GPT-6 SolとLunaの違いを判断するには、名称や第三者の評判ではなく、公式仕様と自社業務での同一条件テストが必要です。「Solは高性能」「Lunaは安くて速い」という説明だけでは、どの業務へ使うべきか決まりません。重要なのは、担当者が日常的に扱う資料や制約で、正確性、指示順守、修正時間、総コストにどの差が出るかです。
比較の順番は、公式情報の確認、評価課題の作成、同一条件での実行、品質と総コストの集計、採用判断です。プロンプト、入力、実行回数、採点者を固定しなければ、モデル差ではなく条件差を測ることになります。文章の好みだけで選ばず、重大な誤りと人の修正負担を数字にしてください。
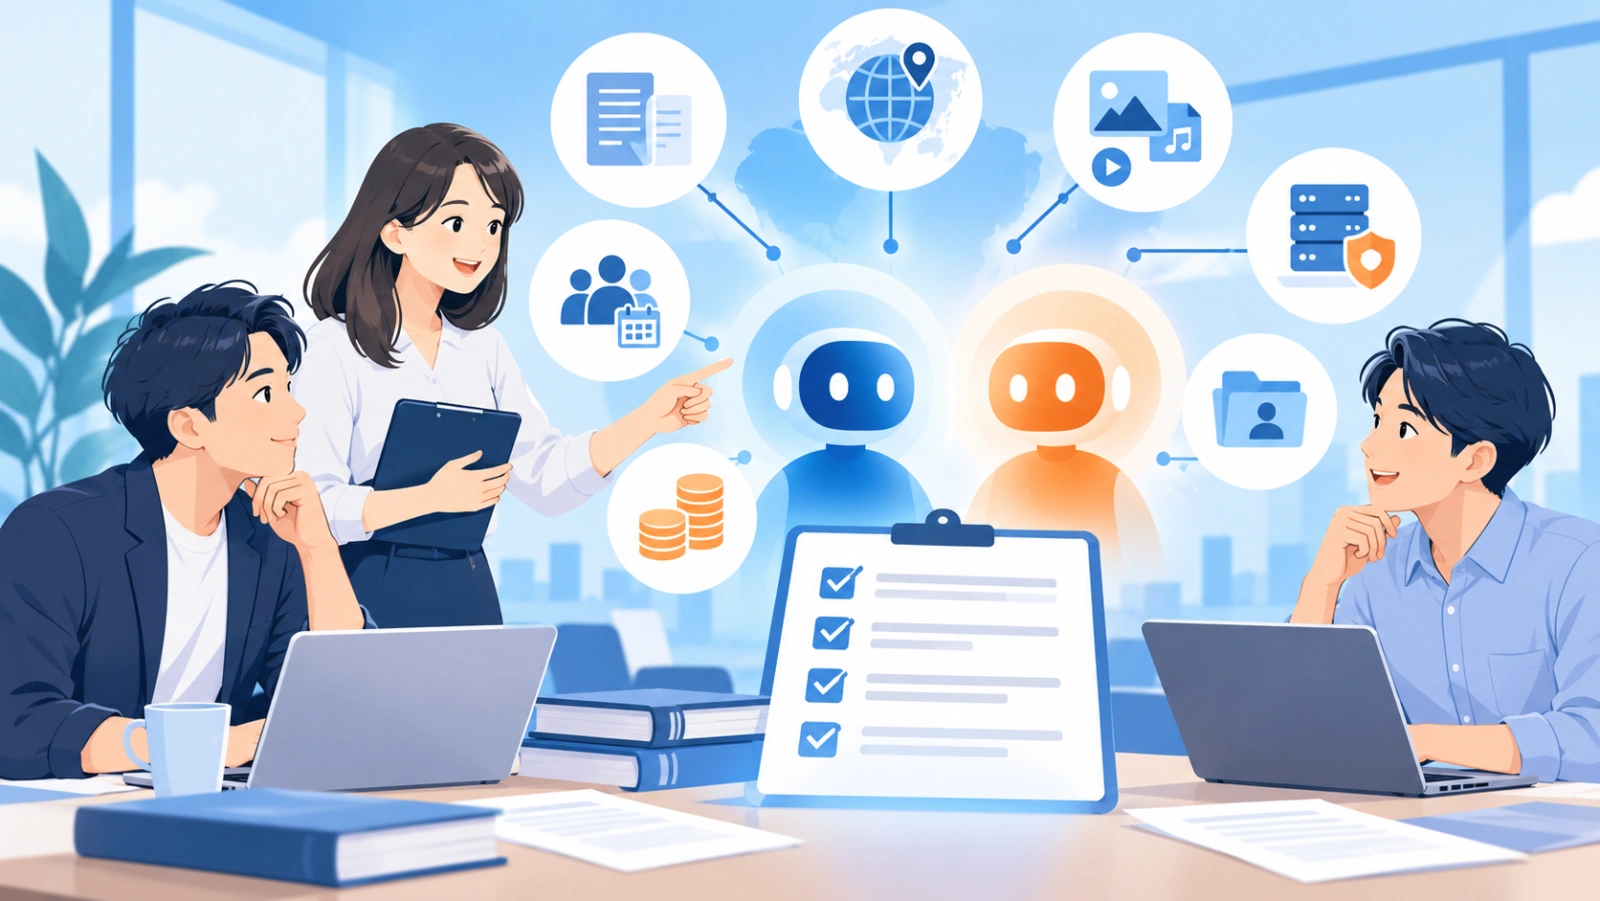
モデルを一つに統一する必要もありません。重要な分析はSol、大量の定型処理はLunaという使い分けも可能です。この記事の表とテンプレートを使い、業務ごとの採用基準を作ります。
業界・職種別「生成AI活用事例集」全11種 無料ダウンロード
最初に公式情報で確認する項目
| 確認項目 | 記録する内容 | 確認先 |
|---|---|---|
| 正式名称 | 製品名、APIモデルID | 公式発表・API文書 |
| 提供範囲 | 対象プラン、地域、利用開始日 | 製品ページ |
| 入出力 | 文章、画像、音声、ファイルなど | 機能説明 |
| 利用上限 | コンテキスト、回数、速度制限 | 技術文書 |
| 料金 | 入力、出力、追加機能の単価 | 公式料金ページ |
| データ管理 | 保存、学習利用、管理者設定 | 法人向け規約 |
取得日とURLを残し、ChatGPT上の表示名とAPIモデルIDを混同しないようにします。
どの軸で比較すればよい?
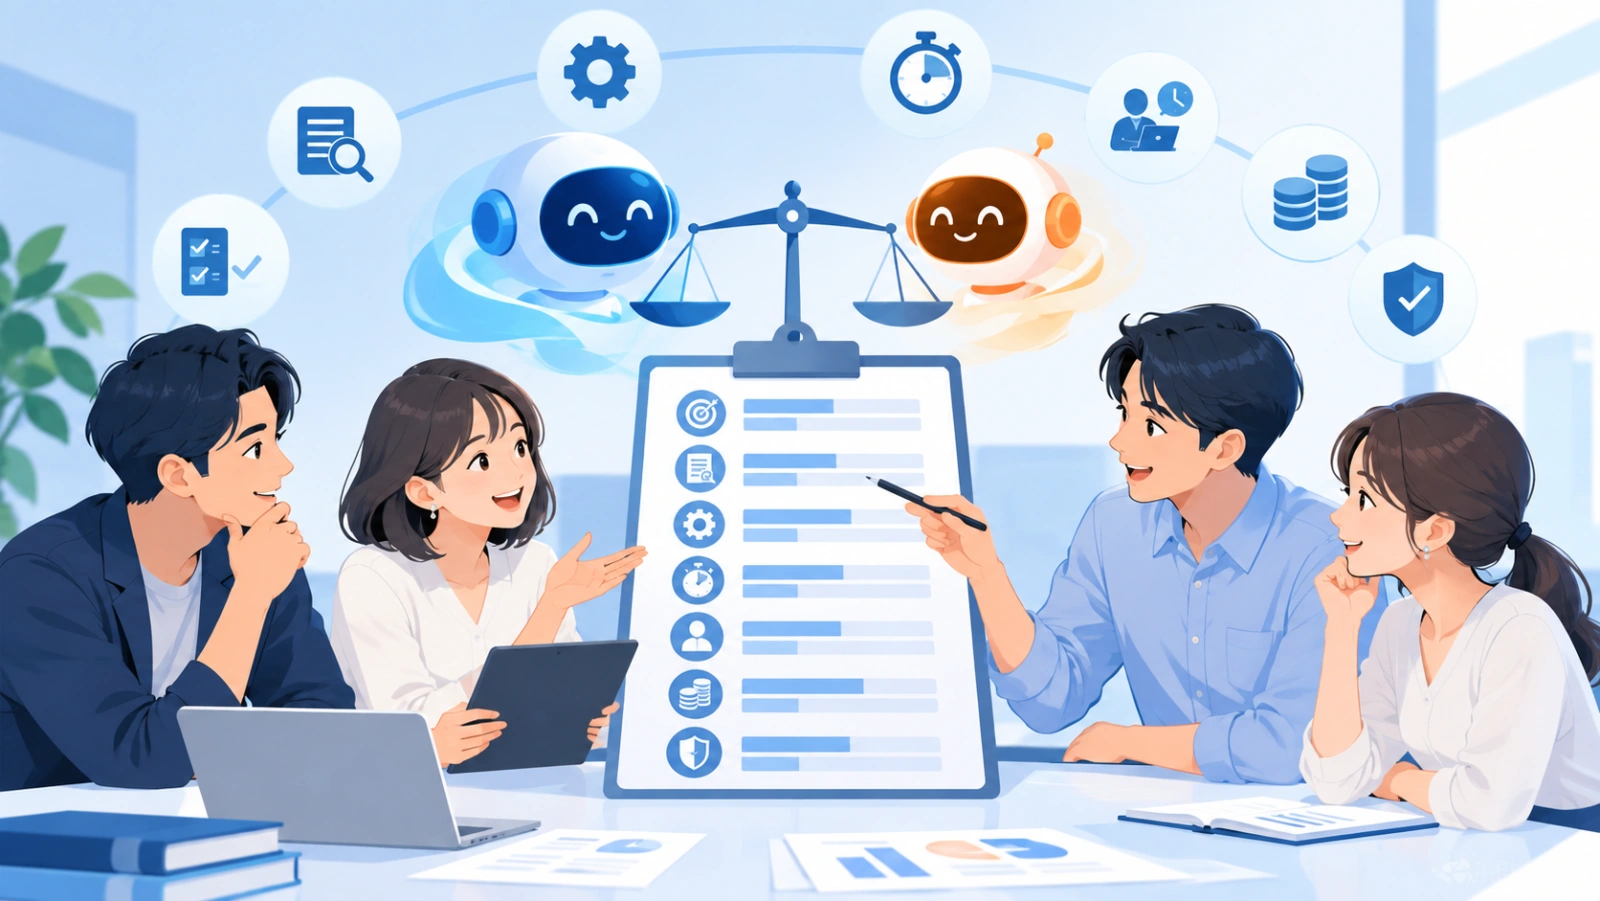
| 比較軸 | 測定方法 | 業務への影響 |
|---|---|---|
| 正確性 | 元資料との不一致を数える | 確認・修正の負担 |
| 指示適合 | 必須条件の達成率を見る | 出力の再現性 |
| 安定性 | 同じ課題を複数回実行する | 運用のしやすさ |
| 処理時間 | 開始から確認完了まで測る | 待ち時間 |
| 修正時間 | 人が直す時間を測る | 実際の効率 |
| コスト | 一件と月間で試算する | 予算への影響 |
| 管理性 | 権限、ログ、停止手順を確認 | 法人利用の安全性 |
ベンチマークの順位だけでなく、自社業務での修正時間を含めて評価します。
そのまま使える比較テスト
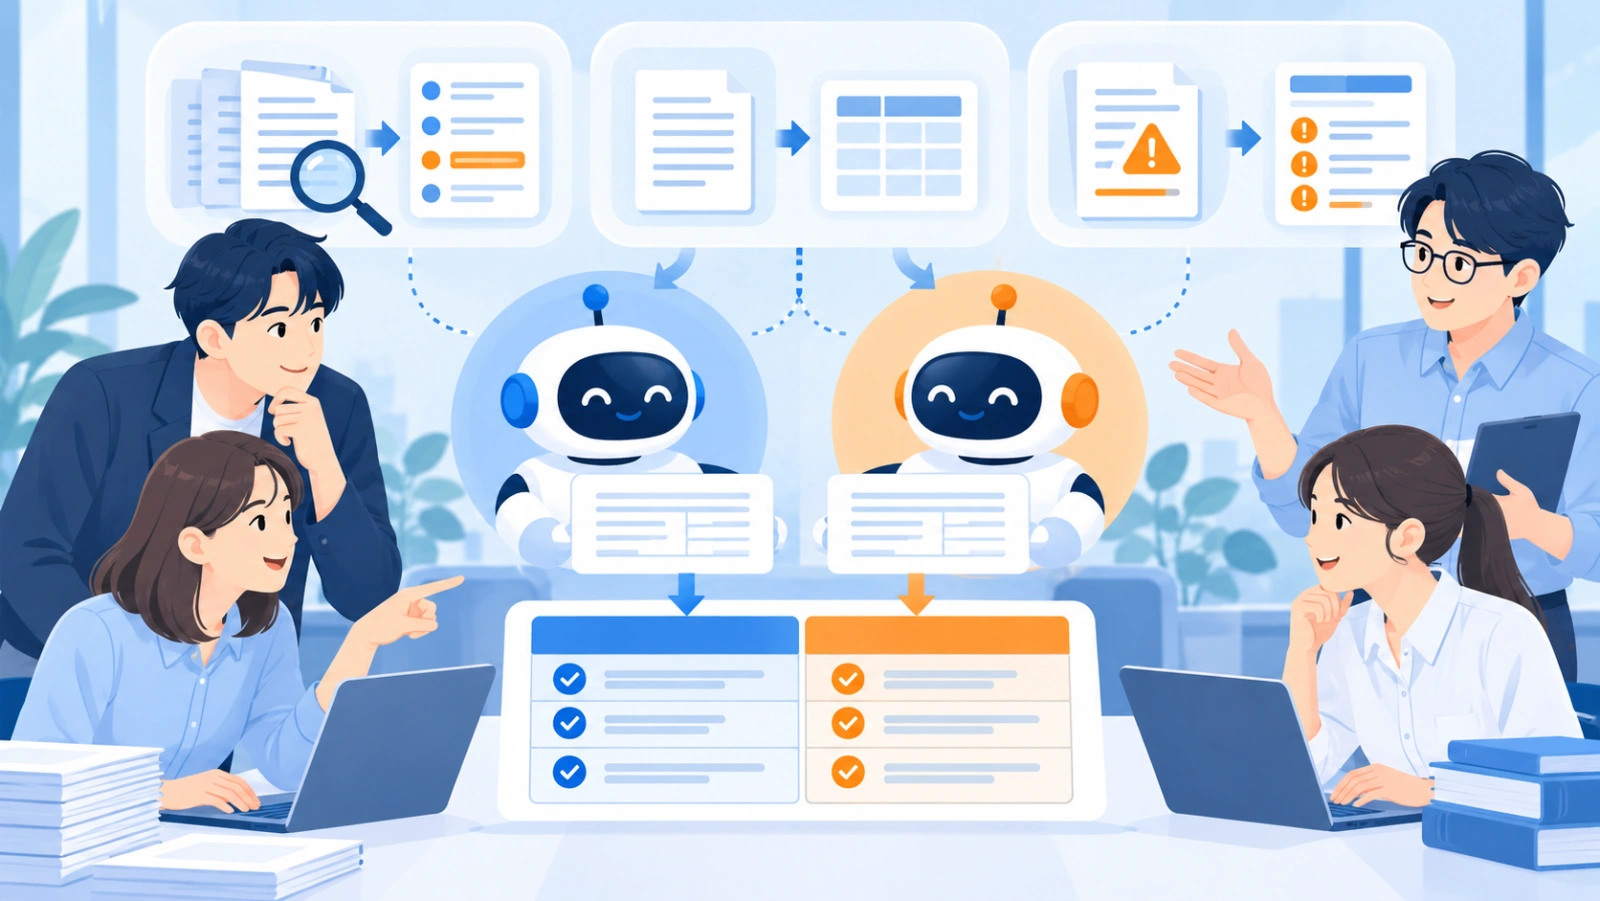
3種類以上の課題を用意します。
- 長文資料から決定事項と根拠を抽出する
- 制約の多い文書を指定形式で作る
- 誤りを含む案をレビューして問題点を指摘する
次の資料だけを使い、決定事項、根拠、未確認事項を整理してください。
条件:資料にない情報を補わない。各項目に該当箇所を示す。
出力:表形式。
両モデルへ同じ入力、同じ設定、同じ回数で実行します。途中でプロンプトを変えた場合は別テストとして記録してください。
評価シート
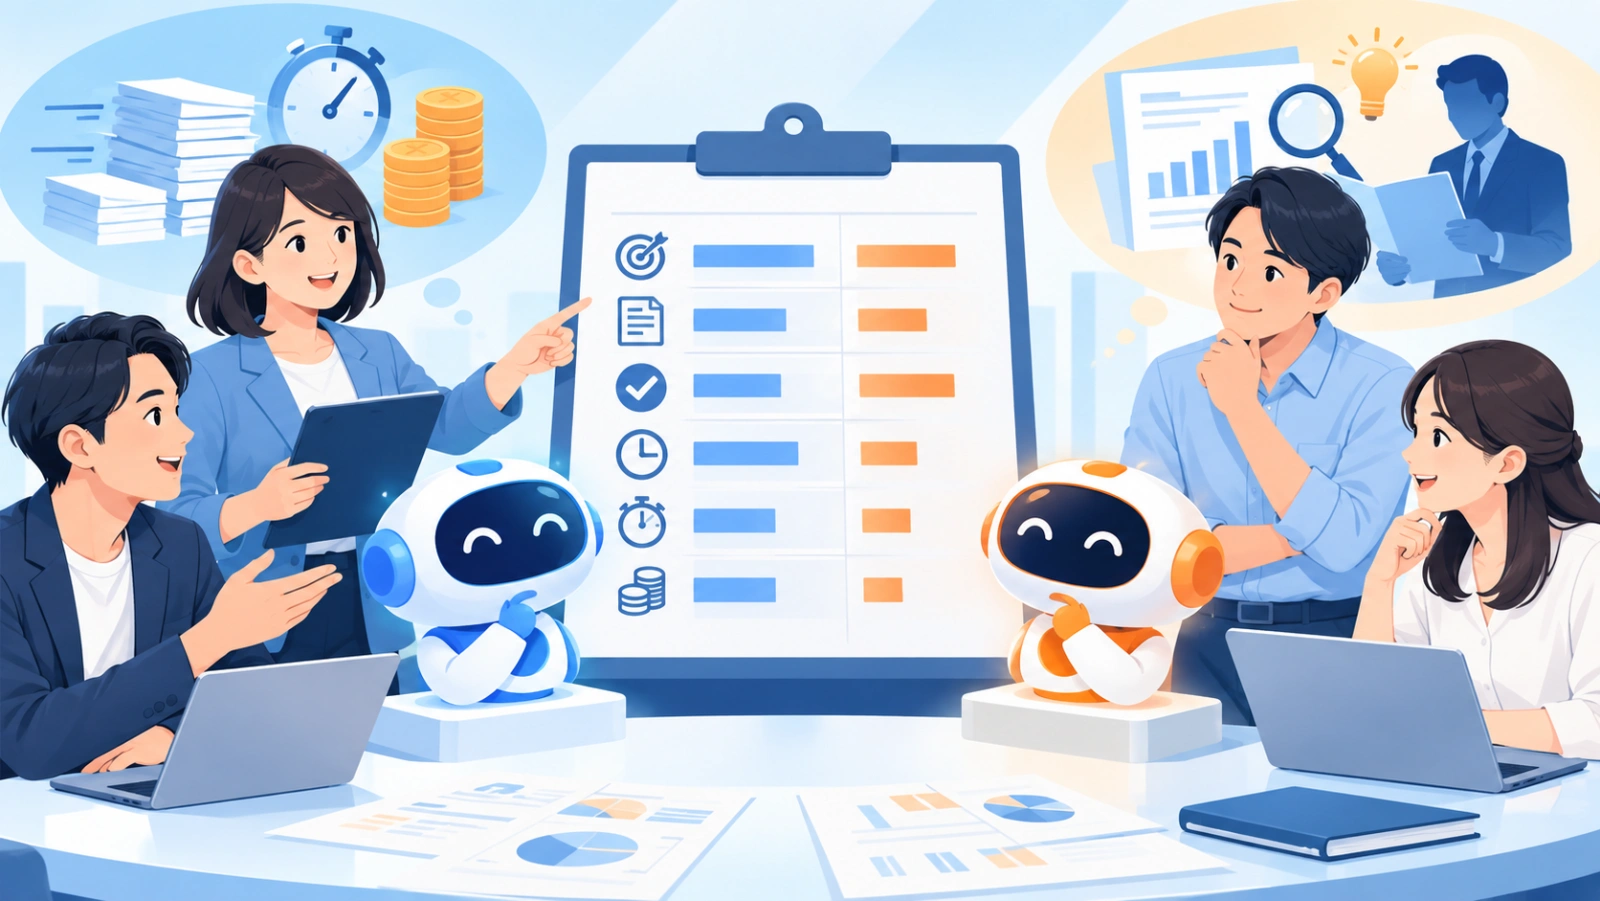
| 項目 | 配点 | Sol | Luna | 確認メモ |
|---|---|---|---|---|
| 事実の正確性 | 30 | |||
| 指示への適合 | 20 | |||
| 抜け漏れの少なさ | 15 | |||
| 修正時間 | 15 | |||
| 処理時間 | 10 | |||
| コスト | 10 | |||
| 合計 | 100 |
配点は業務に合わせて変更します。大量処理ならコストと速度、経営資料なら正確性と抜け漏れの比重を上げます。
総コストを試算する
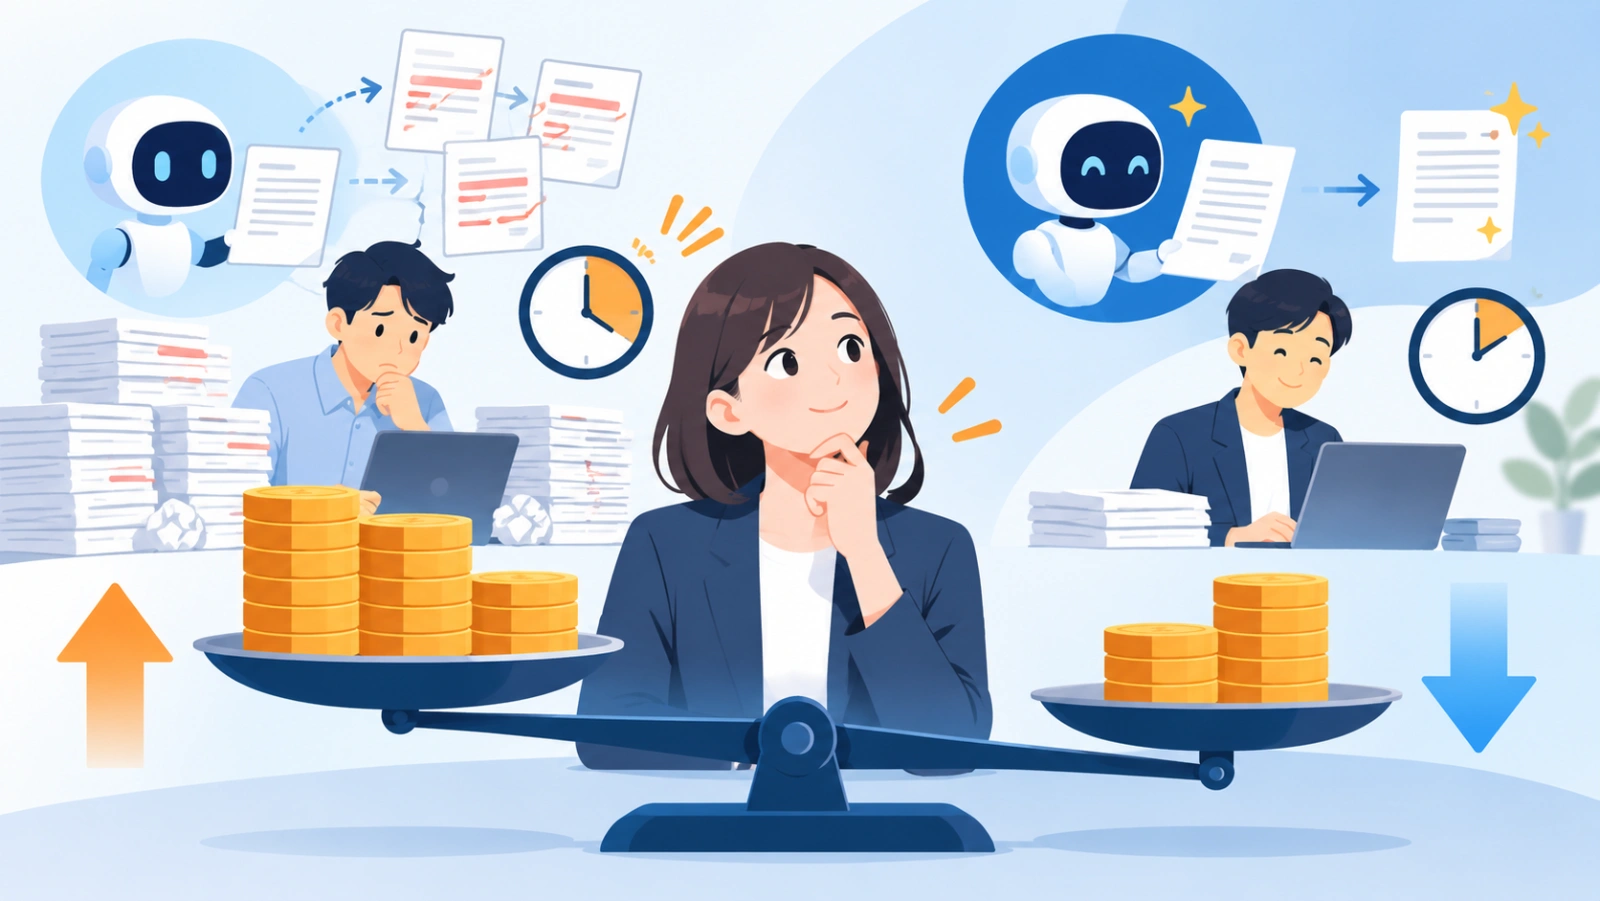
モデル単価だけでなく、人の確認時間を含めます。
月間総コスト = モデル利用料 +(1件の確認・修正時間 × 件数 × 担当者の時間単価)安いモデルでも修正が多ければ総コストは高くなります。逆に単価が高くても、修正が少なく重要業務の品質が上がるなら選択肢になります。
自社に合う研修内容を、業務内容から一緒に整理します
業務別に選ぶ手順
- 大量の定型処理:速度、単価、形式順守を重視
- 複雑な分析:正確性、根拠、長い指示への適合を重視
- 顧客向け文章:表現品質に加えて誤情報と承認フローを重視
- システム連携:API仕様、構造化出力、失敗時の再処理を重視
モデルを全社で一つに統一する必要はありません。業務ごとに採用モデルと代替モデルを決める方法もあります。
比較時のチェックリスト
- 正式名称とモデルIDを確認した
- 公式料金と取得日を記録した
- 同じ入力と条件で比較した
- 3回以上実行してばらつきを見た
- 作成時間ではなく修正時間まで測った
- 機密情報を使わず検証した
- 採用基準と中止基準を先に決めた
同一条件で行う2つの比較検証
SolとLunaの比較では、別々の業務や異なるプロンプトを使うと判断を誤ります。入力、設定、回数、採点者を固定してください。
1. 長文資料から決定事項を抽出する
検証用の架空会議録を用意し、決定事項、未決事項、担当者、期限を抽出させます。資料にない担当者や期限を補った場合は誤りとして数えます。
次の会議録だけを使い、決定事項、未決事項、担当者、期限を表にしてください。
記載がない項目は「未定」と書き、文脈から補わないでください。
各行に根拠となる発言を短く添えてください。
両モデルで3回ずつ実行し、必須項目の達成率、事実誤認、形式違反、修正時間を記録します。速度だけでなく、人が確認して完成させるまでの合計時間を比較します。
2. 制約の多い文書を作る
架空の社内案内を使い、300字以内、指定順序、禁止表現、元情報限定などの条件を与えます。
| 評価項目 | 配点 | 採点方法 |
|---|---|---|
| 事実の正確性 | 30 | 元情報との不一致件数 |
| 指示順守 | 25 | 必須条件の達成率 |
| 抜け漏れ | 15 | 必須項目の不足数 |
| 修正時間 | 15 | 人が直した分数 |
| 処理時間 | 5 | 応答完了までの秒数 |
| 総コスト | 10 | 利用料と確認作業 |
文章の好みは採点者間でぶれやすいため、先に許容例と失敗例を作ります。
比較結果を業務へ反映する方法
一つの合計点だけで全社標準モデルを決める必要はありません。重要な分析はSol、定型的で大量の処理はLunaというように、業務ごとの採用基準を作ります。
- 高リスク業務は正確性と根拠を優先する
- 大量処理は速度、単価、形式順守を優先する
- 顧客向け出力は修正時間と承認を重視する
- API連携は失敗時の再処理とモデル切り替えを確認する
モデル更新時に再評価できるよう、プロンプト、入力、採点表、取得日、モデルIDを保存してください。
よくある質問
どちらが高性能ですか?
公式仕様と同一条件の実測がなければ判断できません。業務ごとに必要な品質も異なります。
料金が安い方を選べばよいですか?
モデル利用料だけでなく、確認・修正時間を含む総コストで比較します。
既存モデルからすぐ移行すべきですか?
限定した業務で並行テストし、品質、コスト、管理条件が基準を満たした場合に移行します。
MoMoなら業務成果から逆算したモデル選定を実現できます
株式会社MoMoでは、公開ベンチマークだけでなく、実際の業務データ、確認時間、総コスト、安全性を使ってモデルを比較します。
1. 向いている企業・向いていない企業
複数モデルを業務ごとに使い分けたい企業に向いています。名称や評判だけで全社導入を決めたい場合は、先に評価課題と合格基準を作る必要があります。
2. 活用例
検証用の架空会議録と社内案内をSol・Lunaへ同一条件で入力し、正確性、指示順守、修正時間を比較します。
業界・職種別の活用事例11種を無料で配布しています
まとめ
GPT-6 SolとLunaは、公式仕様を確認したうえで、自社業務に近い課題を同一条件で実行して比較します。正確性、指示適合、安定性、修正時間、総コスト、管理性を評価してください。
最初の行動は、比較対象にする業務を一つ選び、合格基準と3つのテスト課題を作ることです。
まずは比較対象の業務を一つ選び、同じ入力と採点表でSol・Lunaを3回ずつ試してください。
比較結果を記録できる評価観点を増やしたい方は、「生成AI活用事例50選」から自社に近い業務を選べます。モデル選定やAPI運用まで具体化する段階では、個別相談を活用してください。
研修内容・費用のご相談は無料です