Jevとは、状態を受け取り、あらかじめ定義した形式で判断結果を返すAIモデルです。ChatGPTのように会話文や記事を書くモデルではありません。業務システムやAIエージェントの中で、候補の選択、リスク評価、人による確認が必要かどうかの判定に使います。
この違いは、単なる出力形式の違いではありません。自由文を生成するAIへ「次に何をするべきか」と聞くと、回答を再びプログラムが解釈する必要があります。Jevは、最初から選択肢や評価基準を定義し、ソフトウェアが扱いやすい値と確率を返します。判断部分を独立させたいシステムで使いやすい設計です。
ただし、型付きの結果だから正しいとは限りません。選択肢が重複している、判断に必要な状態が不足している、業務基準が曖昧である場合は、安定した運用ができません。Jevの導入はモデル選定よりも、判断基準と失敗時の経路を設計する仕事だと考えてください。
業界・職種別「生成AI活用事例集」全11種 無料ダウンロード
Jevとは何をするAI?
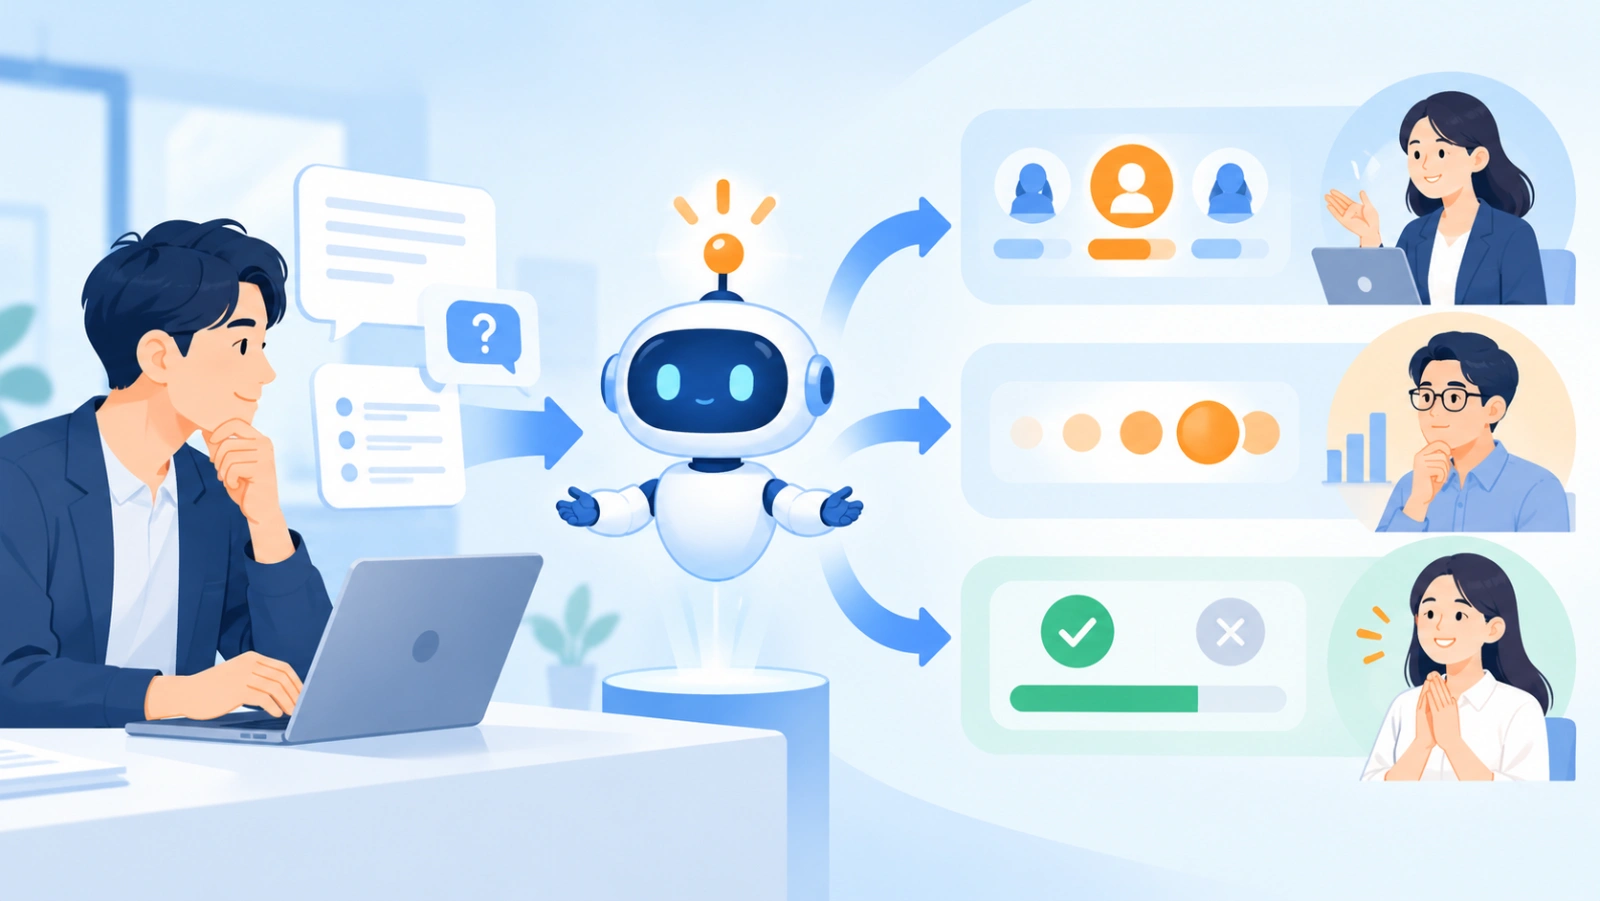
Jevへ渡すのは、判断に必要な状態と質問です。返ってくるのは自由文ではなく、型が決まった結果と確率です。公式ドキュメントでは、候補から一つを選ぶchoice、段階評価を返すscore、Yesの確率を返すnoulが案内されています。[[1]](https://docs.typesafe.ai/introduction/coding-agents)
| 形式 | 返す内容 | 利用例 |
|---|---|---|
| choice | 候補と各確率 | 問い合わせの振り分け |
| score | 定義した段階評価 | リスク・優先度の評価 |
| noul | Yesである確率 | 人の承認が必要かの判定 |
ChatGPTのような文章生成AIと何が違う?
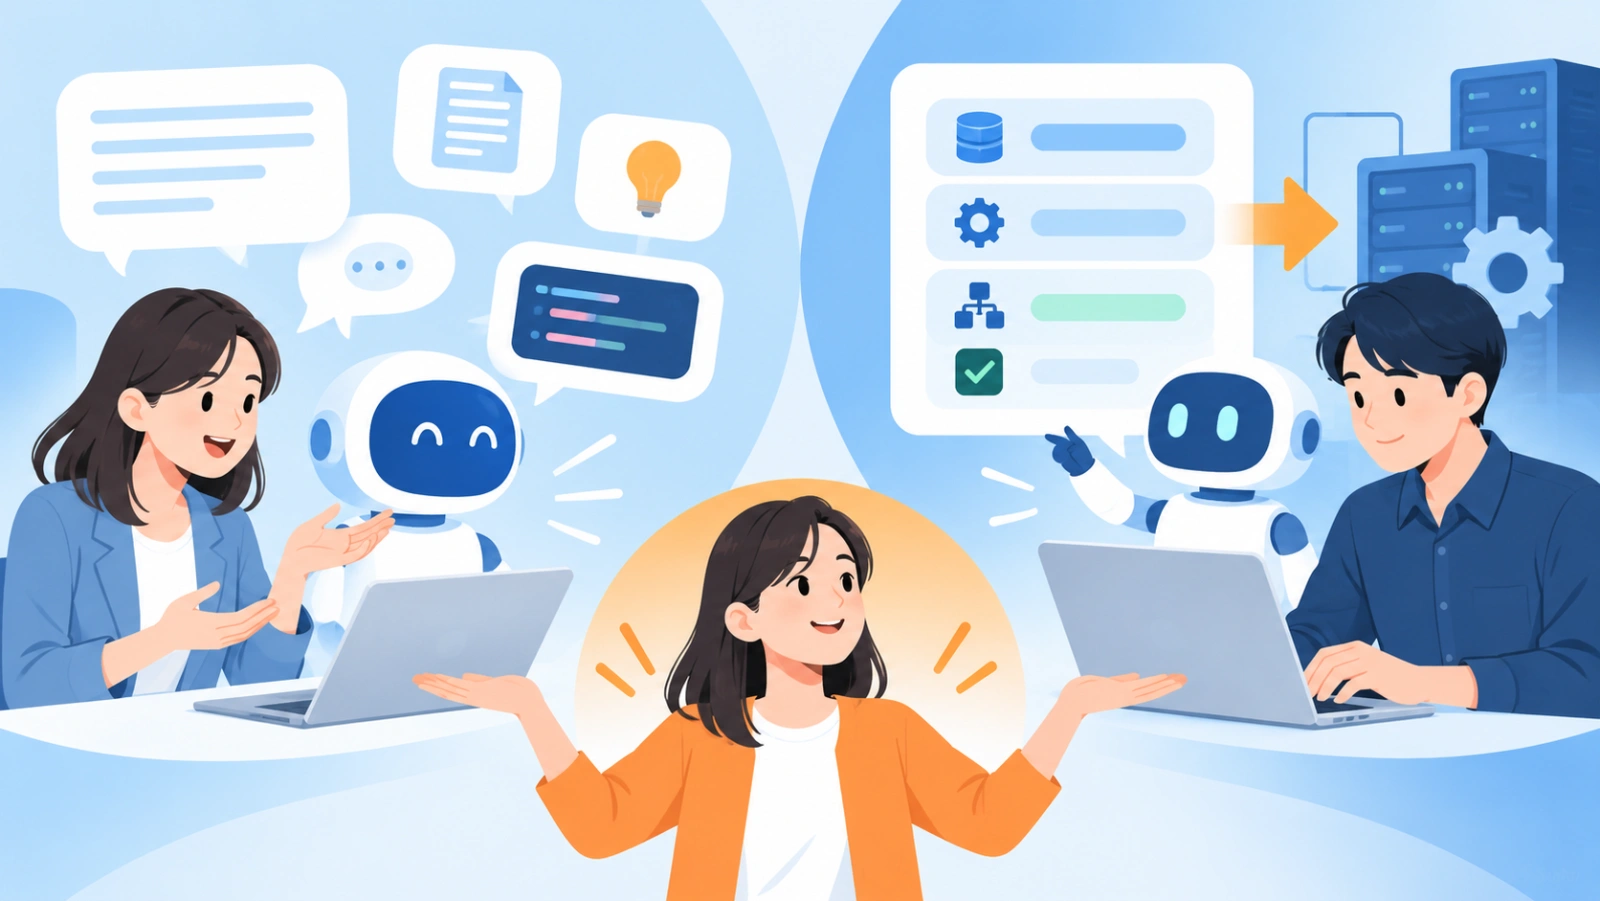
最大の違いは出力の目的です。ChatGPTは説明、要約、コード、会話などの自由文生成を得意とします。一方のJevは、システムがそのまま処理しやすい限定された値を返します。
JevはLLMの代替ではありません。公式資料も、Claude Code、Cursor、Copilotなどの背後にあるLLMを置き換えるものではないと説明しています。[[1]](https://docs.typesafe.ai/introduction/coding-agents)
Jevが向いている3つの場面
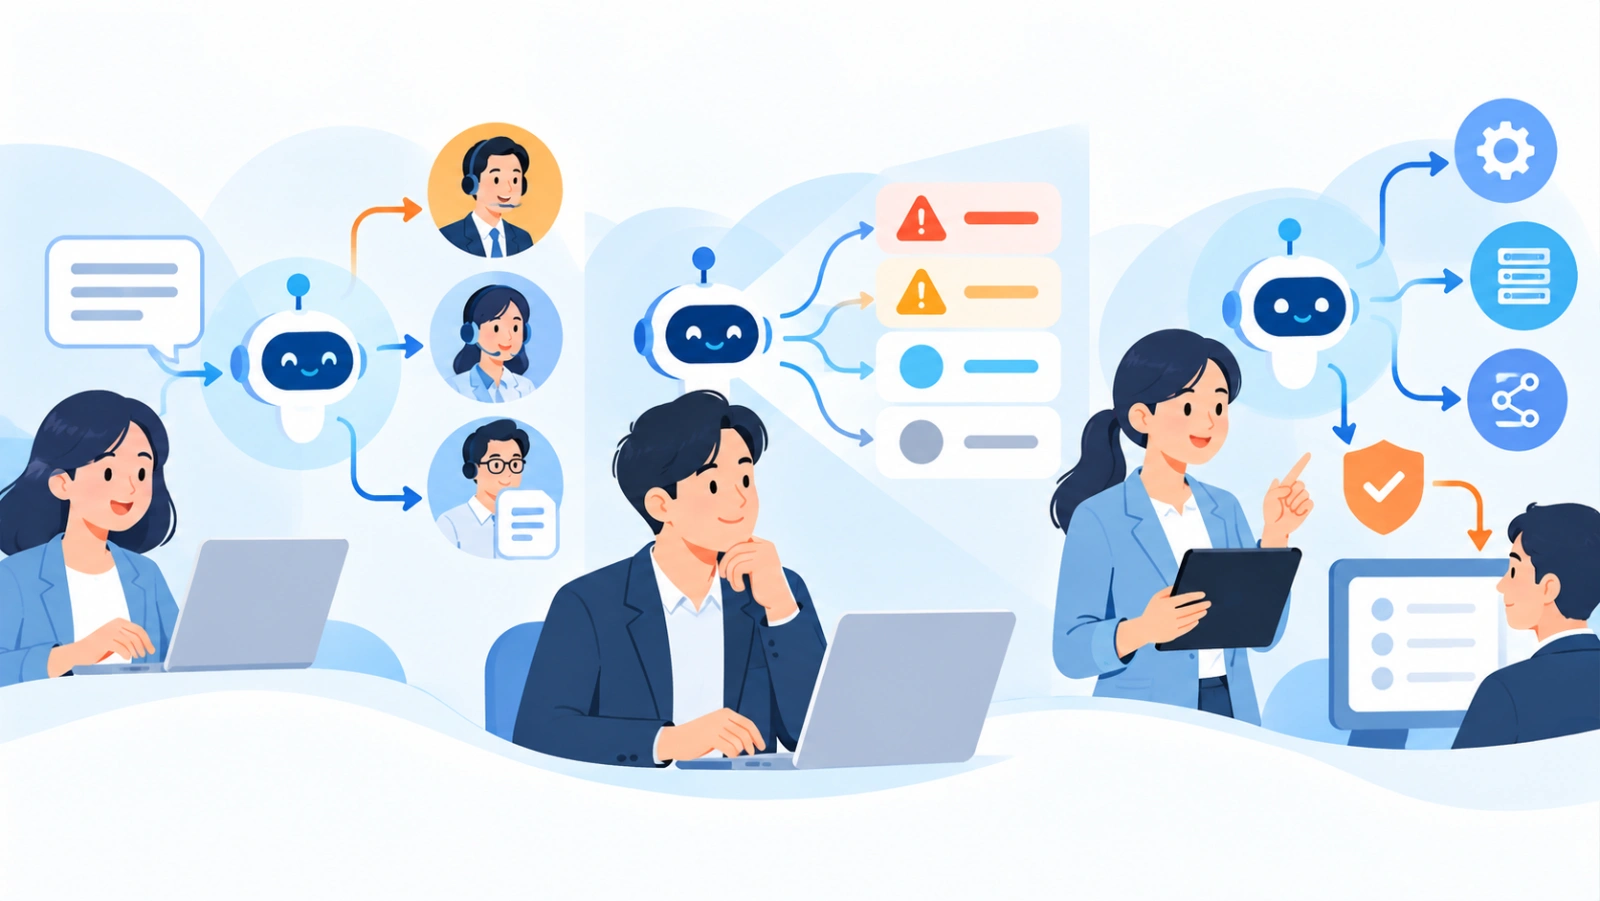
1. 候補から一つを選ぶ
問い合わせを「営業」「サポート」「請求」に分ける、複数の処理経路から次の一手を選ぶ、といった場面です。候補を事前に限定するため、自由文を後処理する負担を減らせます。
2. リスクや優先度を評価する
「低・中・高・重大」のような基準を用意し、入力状態を評価させます。確率も確認できるため、低い確信度だけ人へ回す設計が可能です。
3. AIエージェントの判断を補助する
ツール実行前のガード、モデルの振り分け、タスクの経路選択などに使えます。ただし、Jev自身が送金や削除を実行するわけではありません。実行権限と最終承認はホスト側のシステムで管理します。
導入前に決める5項目
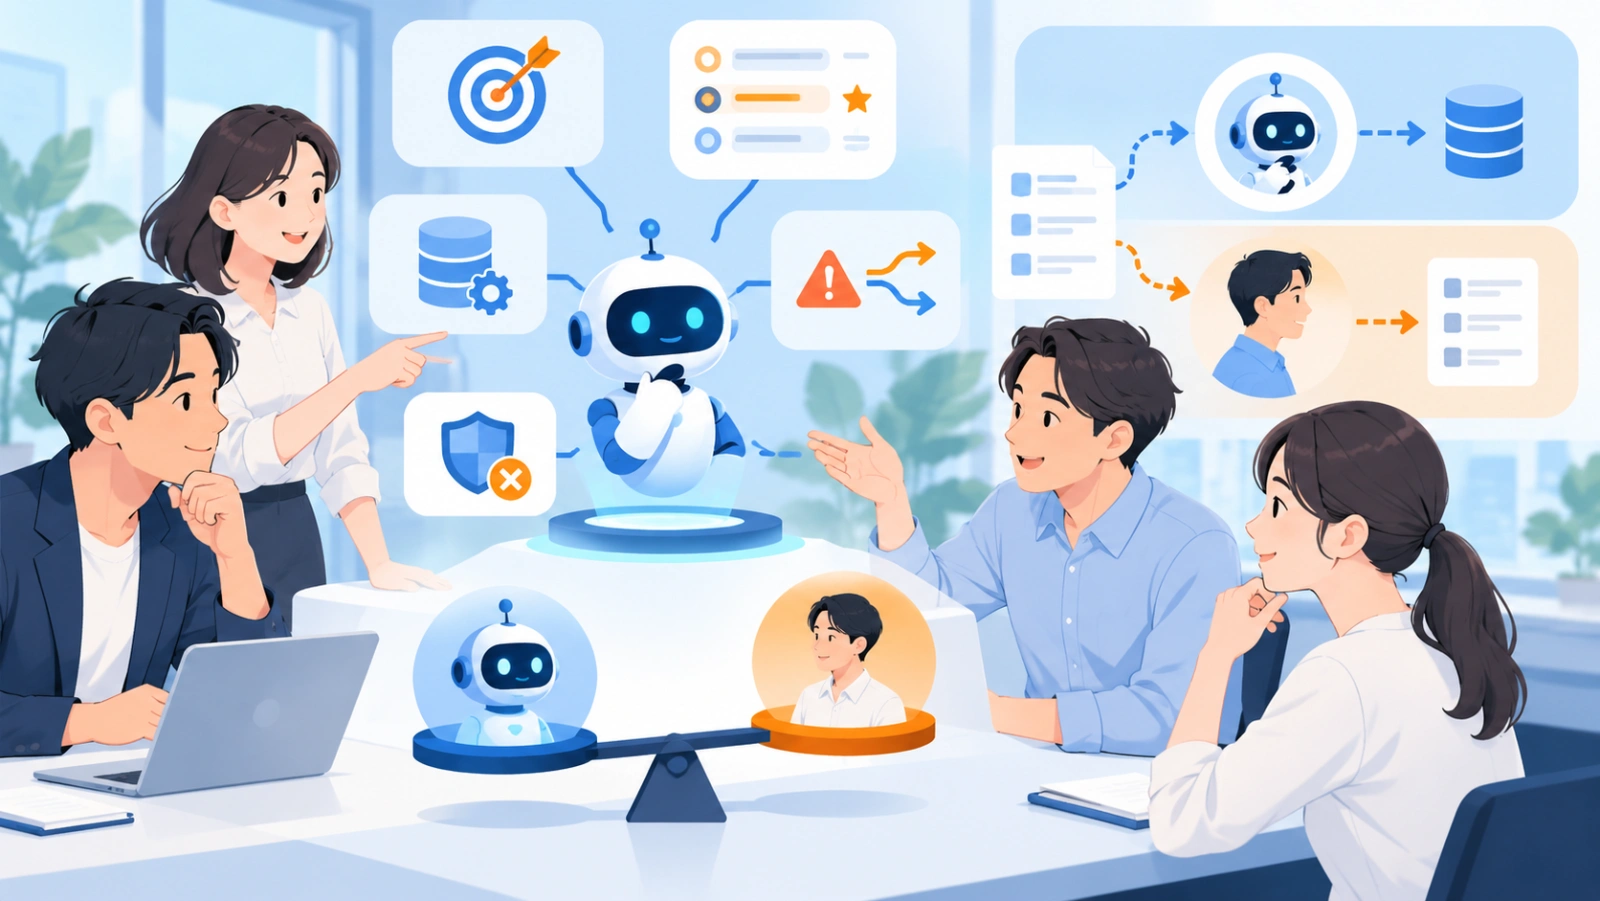
- どの判断をJevへ任せるか
- 返せる候補と評価基準
- 判断に必要な最小限の状態
- 確信度が低い場合の処理
- 誤判定時に停止・差し戻す方法
重要な処理をいきなり自動化せず、まずはログだけ残す「シャドー運用」で人の判断と比較してください。
自社に合う研修内容を、業務内容から一緒に整理します
導入手順
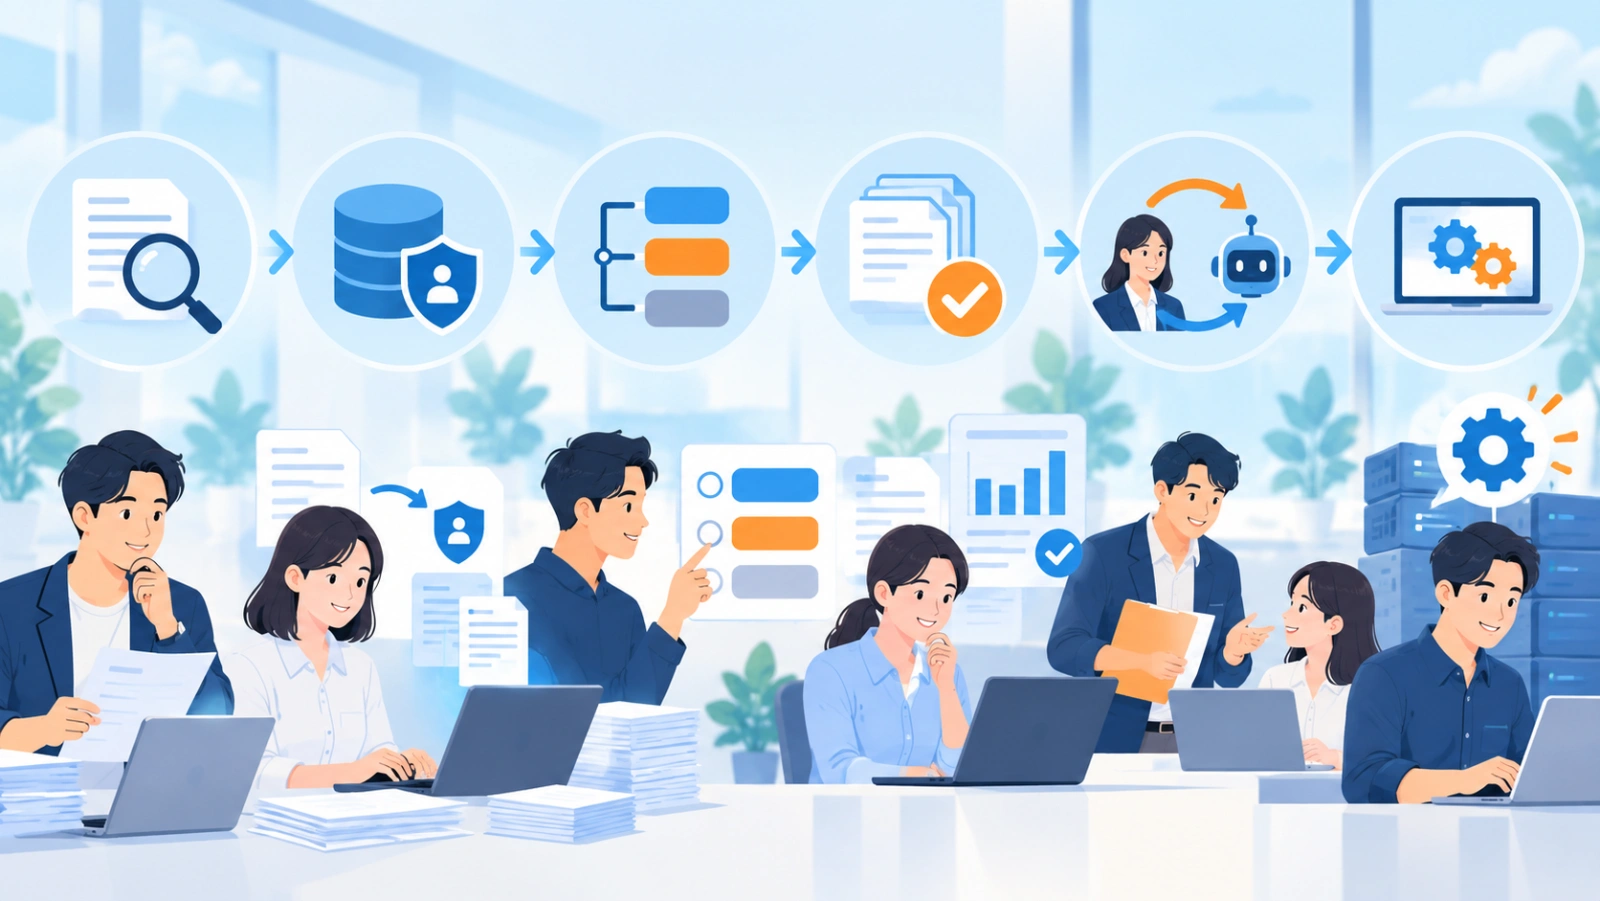
| 手順 | 実施内容 | 確認点 |
|---|---|---|
| 1 | 判断対象を一つ選ぶ | 正解を人が確認できるか |
| 2 | 過去データを匿名化する | 機密情報を除けたか |
| 3 | choice・score・noulを選ぶ | 出力形式が業務に合うか |
| 4 | 50〜100件で検証する | 誤判定と確信度の関係 |
| 5 | 低確信度を人へ回す | 承認経路が機能するか |
| 6 | 限定範囲で自動化する | ログ・停止・再処理があるか |
Jevを使う際の注意点
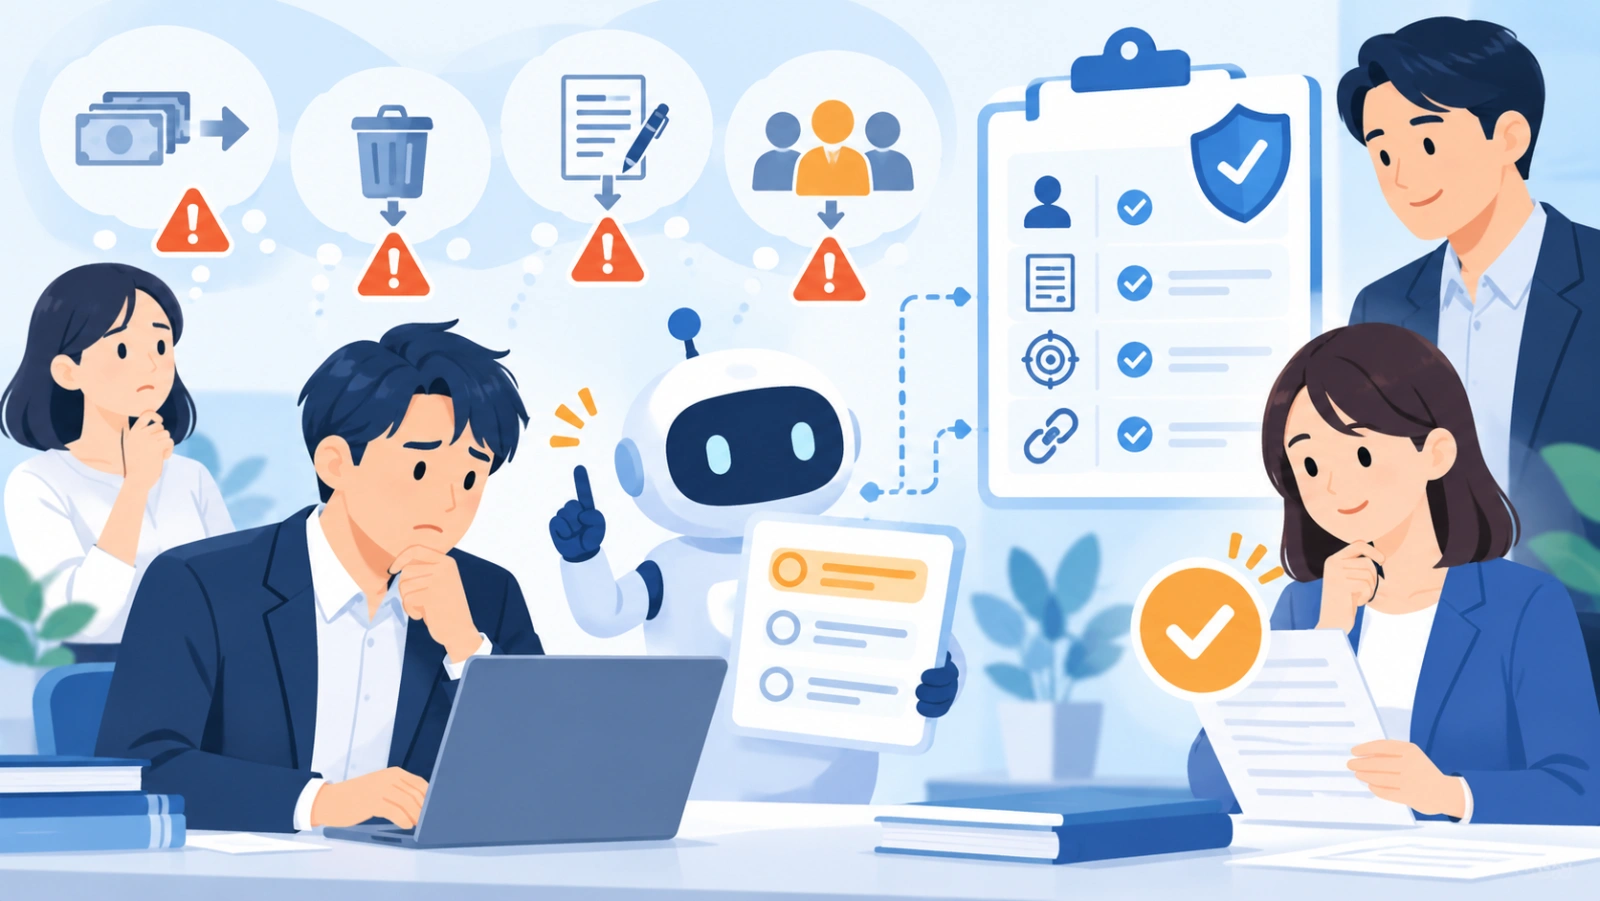
型が決まっていることは、誤りが起きないことを意味しません。選択肢や評価基準が悪ければ、業務に合わない結果になります。また、入力状態に必要な情報が不足していれば、確信度の低い判断になり得ます。
送金、削除、契約、採用など不可逆な処理は、アプリケーション側で権限、入力値、対象範囲、リクエストIDを検証し、人の承認を残してください。
3つの出力型を業務要件へ落とし込む
Jevを導入するときは、技術上の型をそのまま使うのではなく、業務上の意味と対応づけます。
1. choiceは候補の境界を先に決める
問い合わせ分類で「営業」「製品相談」「導入相談」が重複していると、正解を定義できません。各候補に含む例・含まない例を作り、担当部署の責任範囲と一致させます。
2. scoreは段階ごとの行動を決める
「低・中・高・重大」という値だけでは運用できません。
| score | 業務上の意味 | 次の行動 |
|---|---|---|
| 低 | 通常手順で処理可能 | 自動で担当キューへ送る |
| 中 | 情報不足または例外あり | 担当者が確認する |
| 高 | 金銭・顧客影響が大きい | 管理者が承認する |
| 重大 | 実行すべきでない | 処理を停止して記録する |
3. noulは閾値を固定せず検証する
Yes確率が0.8以上なら承認へ回す、と先に決めても、その値が妥当とは限りません。過去データで誤判定と確率の関係を確認し、見逃しコストが高い業務ほど安全側の閾値を選びます。
Jevの導入効果を測る指標
| 指標 | 確認する理由 |
|---|---|
| 人との一致率 | 業務基準に合っているか |
| 重大な見逃し | 平均値では見えない危険を把握する |
| 低確信度率 | 人へ回る件数を見積もる |
| 応答時間 | リアルタイム処理へ使えるか |
| 差し戻し率 | 後工程の負担を確認する |
| 一件あたり総コスト | APIと人の確認を合わせて判断する |
精度だけを追うと、すべて人へ回す安全すぎる設計になる場合があります。自動処理率と重大な見逃しを同時に確認してください。
よくある質問
Jevだけでチャットボットを作れますか?
自由文を生成しないため、Jevだけで一般的なチャットボットを作る用途には向きません。会話用LLMと組み合わせ、意図分類や次の処理の選択に使います。
JevはAIエージェントですか?
Jev自体はツールを実行するエージェントではなく、エージェント内で判断を返すモデルです。
導入時に最初に試す業務は?
選択肢が明確で、人が正解を確認でき、誤判定してもすぐ止められる業務から始めます。
MoMoなら業務成果から逆算したAI導入設計を実現できます
新しいAIを導入するときは、モデルの特徴より先に、対象業務、判断基準、人の確認、停止条件を決める必要があります。株式会社MoMoでは、業務の棚卸しから検証設計、運用ルール、研修までを支援します。
1. 向いている企業・向いていない企業
判断業務を標準化し、ログを残して改善したい企業に向いています。判断基準が定まらないまま完全自動化だけを求める場合は、先に業務設計が必要です。
2. 活用例
検証用の架空データで問い合わせ振り分けを再現し、人の判定との一致率、低確信度の件数、差し戻し手順を確認してから対象範囲を広げます。
業界・職種別の活用事例11種を無料で配布しています
まとめ:判断業務を一つ選んで小さく検証しよう
Jevは自由文を作るAIではなく、限定された形式で判断を返すSystem One Modelです。choice・score・noulを使い分け、LLMや業務システムの判断部分を補助します。
まずは社内の判断業務を一つ選び、候補、評価基準、人へ戻す条件を書き出したうえで、過去データと人の判断を比較してください。
Jev以外も含むAI活用候補を比較したい方は、「生成AI活用事例50選」が業務選定に役立ちます。判断モデルをシステムへ組み込む段階では、個別相談を活用してください。
研修内容・費用のご相談は無料です